Fachartikel · KI
Eine KI liefert eine Antwort - und dann beginnt die eigentliche Arbeit: Ergebnisse prüfen, Daten abgleichen, Zuständigkeiten klären und Freigaben einholen. Genau dieser Aufwand gehört in die Diskussion über KI-Produktivität. Neben der Frage, was ein Modell kann und welche Tätigkeiten es übernimmt, interessiert mich deshalb besonders:
Was kostet es, wenn wir den Ergebnissen einer KI nicht vertrauen?
Entscheidend ist nicht, ob geprüft wird, sondern welcher Aufwand notwendig ist. Prüfung, Datenabgleich, die Klärung von Verantwortlichkeiten und Freigaben gehören ebenso zu den Kosten eines KI-Systems wie Lizenzen, Rechenleistung und Implementierung. Nicht jeder dieser Schritte entsteht aus mangelndem Vertrauen. Die wirtschaftliche Chance liegt darin, notwendige Absicherung von vermeidbarer Mehrfacharbeit zu unterscheiden.
Hier liegt die Chance der Vertrauensdividende: Vertrauenswürdige Daten und risikogerechte Kontrollen können Menschen helfen, KI-Ergebnisse begründet zu nutzen. Dadurch könnten unnötige Prüfungen und Abstimmungen abnehmen und KI-Anwendungen wirtschaftlicher werden. Ich verstehe diesen Zusammenhang als plausibles Wirkmodell: Einzelne Teile sind empirisch gestützt; die gesamte Kausalkette ist bislang nicht nachgewiesen.
Vertrauen kann ein wirtschaftlicher Faktor sein
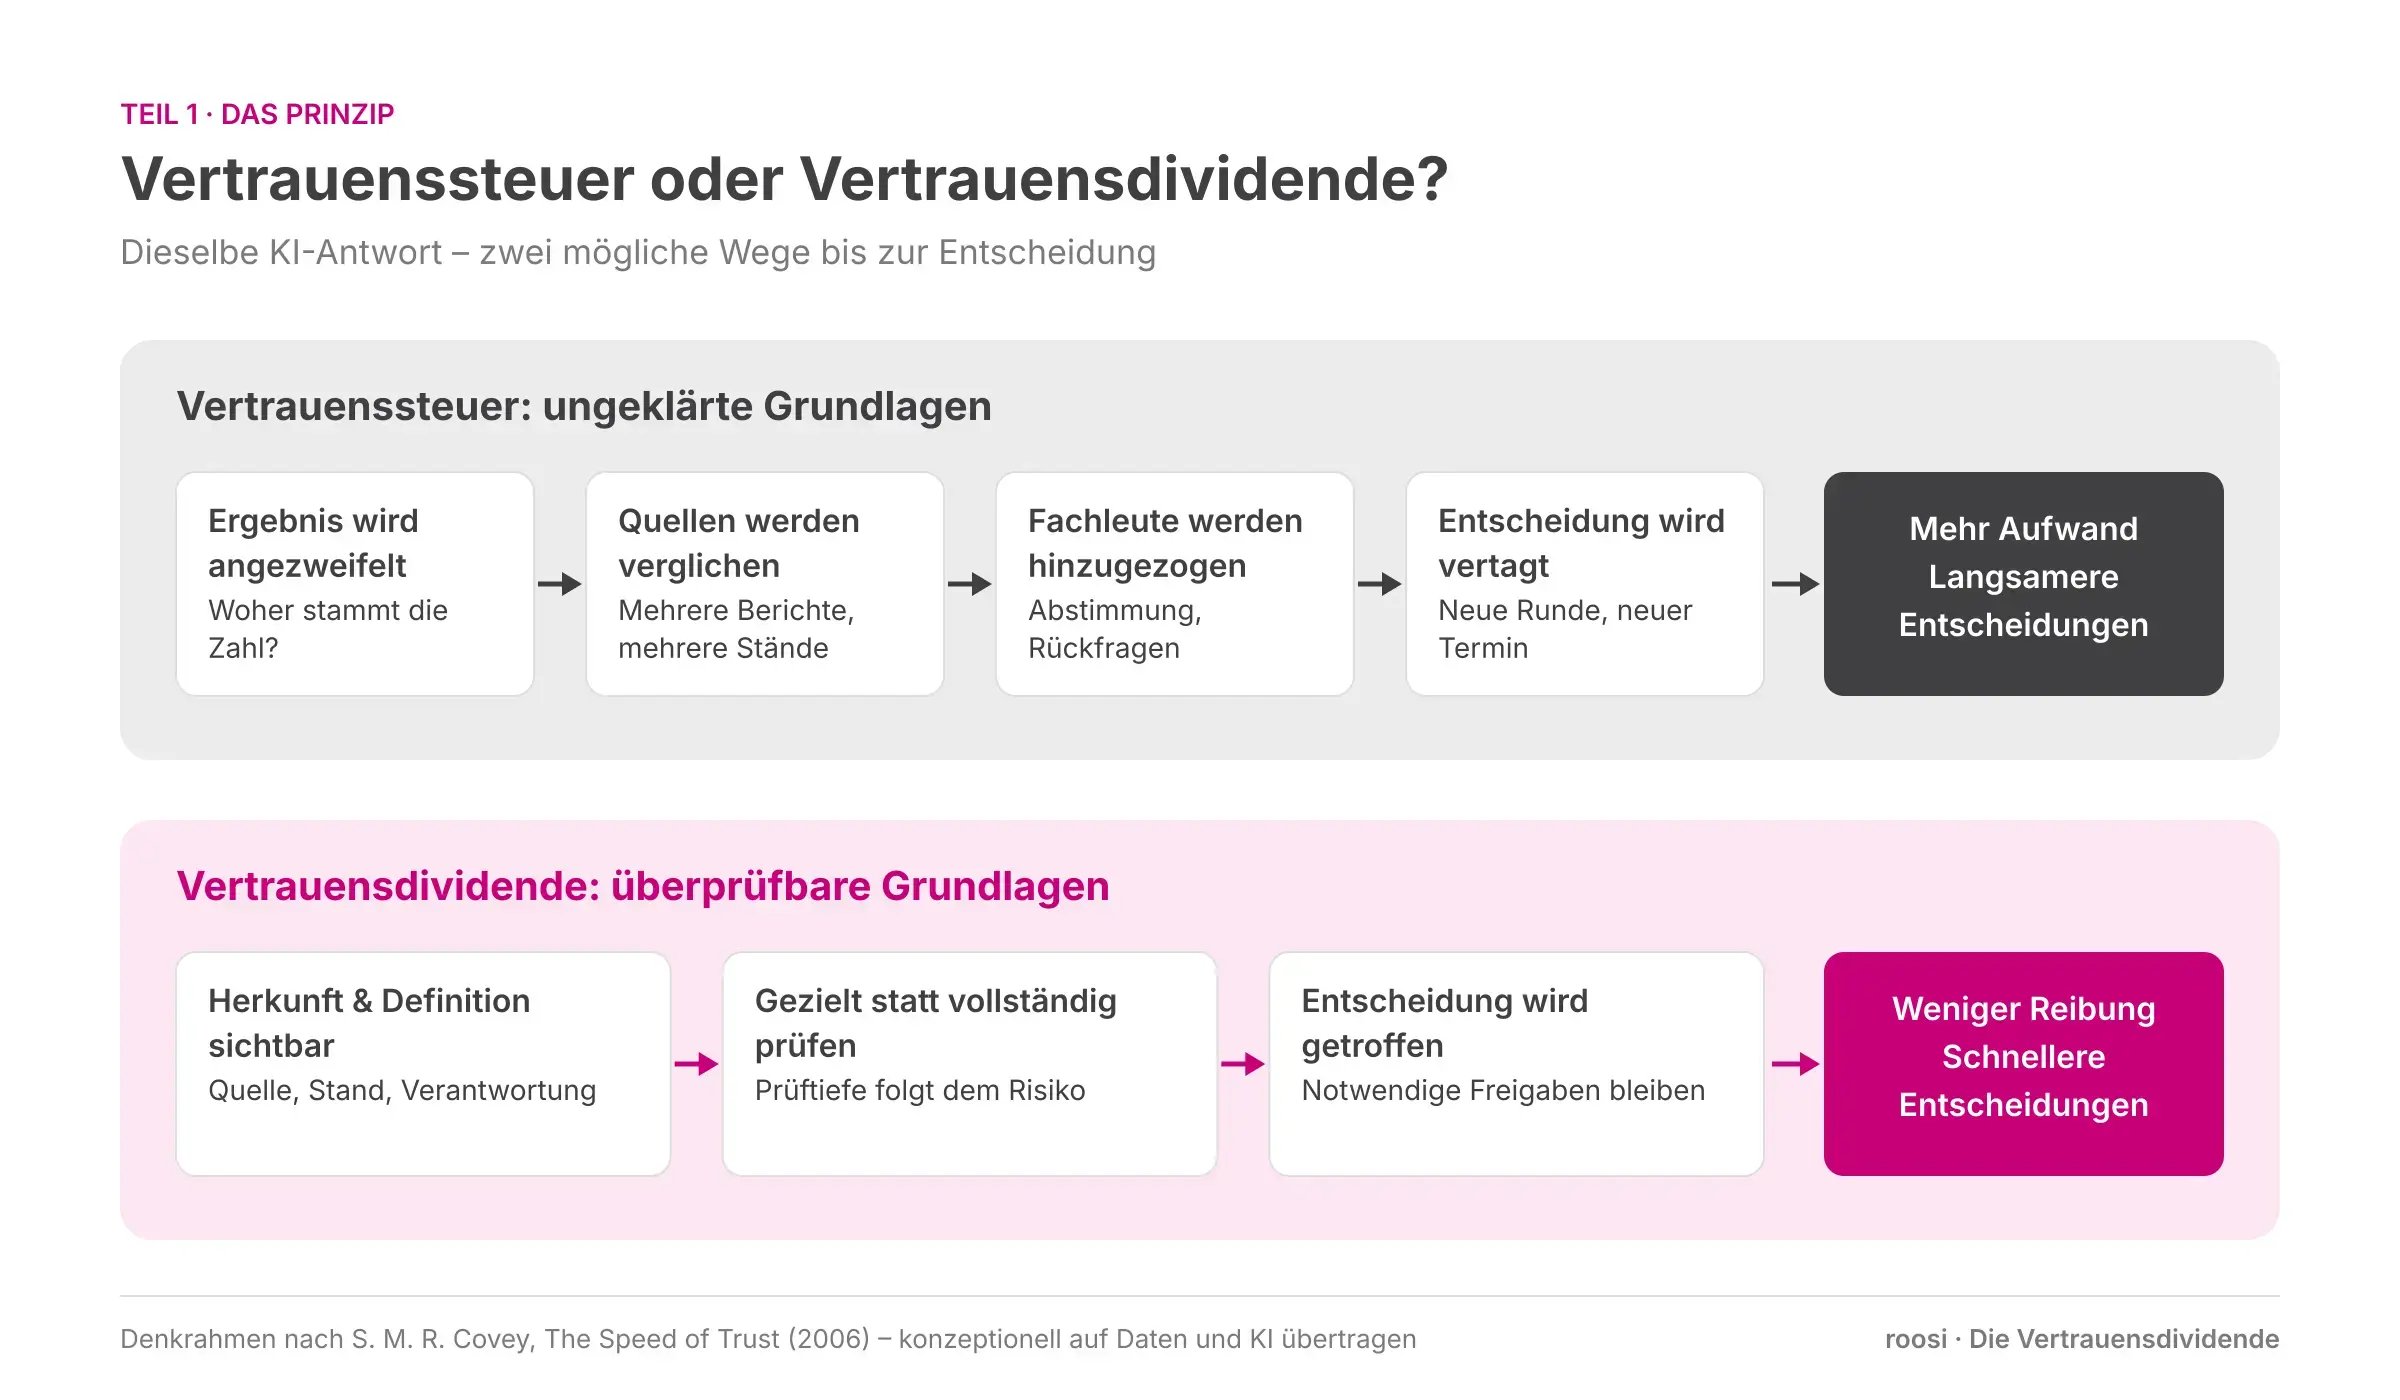
In The Speed of Trust beschreibt Stephen M. R. Covey Vertrauen als eine Größe, die Geschwindigkeit und Kosten beeinflusst. Sinkt das Vertrauen, werden Menschen vorsichtiger. Kommunikation wird zurückhaltender, Entscheidungen werden vertagt und zusätzliche Kontrollen eingeführt. Covey bezeichnet diese Belastungen als „Trust Taxes“, also als Misstrauenskosten.
Ist das Vertrauen dagegen hoch, können Menschen schneller kommunizieren, Verantwortung übernehmen und Entscheidungen treffen. Prozesse werden einfacher und kostengünstiger. Es entsteht eine „Trust Dividend“, eine Vertrauensdividende. Covey fasst den Zusammenhang so zusammen: Bei geringem Vertrauen steigen die Kosten und die Produktivität verlangsamt sich; bei hohem Vertrauen sinken die Kosten und die Produktivität steigt. [franklincovey.com]
Covey denkt Vertrauen dabei nicht als Naivität. Glaubwürdigkeit beruht in seinem Modell auf zwei Komponenten: Charakter und Kompetenz. Integrität und gute Absichten allein reichen nicht aus. Es braucht auch Fähigkeiten, belastbare Ergebnisse und einen überzeugenden Leistungsnachweis. [franklincovey.com]
Für Daten und KI bietet dieser Gedanke eine Arbeitshypothese.
Dabei sind Vertrauenswürdigkeit und Vertrauen zu unterscheiden: Vertrauenswürdigkeit bezeichnet die überprüfbaren Eigenschaften von Daten und Systemen; Vertrauen bezeichnet die Bereitschaft von Menschen, sich für eine bestimmte Aufgabe auf deren Ergebnisse zu verlassen. Begründetes Vertrauen soll sich an nachgewiesener Leistungsfähigkeit, bekannten Grenzen und dem jeweiligen Risiko orientieren. Mehr Vertrauen ist deshalb nicht automatisch besser - entscheidend ist, ob es angemessen ist.
Ein KI-System ist nicht deshalb vertrauenswürdig, weil seine Antworten überzeugend formuliert sind. Es muss auch nachweislich auf geeigneten Daten arbeiten, für seinen Einsatzzweck ausreichend zuverlässig sein und innerhalb klarer Grenzen eingesetzt werden.
| Vertrauenswürdigkeit | Vertrauen | |
|---|---|---|
| Bezeichnet | die überprüfbaren Eigenschaften von Daten und Systemen | die Bereitschaft von Menschen, sich für eine bestimmte Aufgabe auf deren Ergebnisse zu verlassen |
| Maßstab | geeignete Daten, ausreichende Zuverlässigkeit für den Einsatzzweck, klare Grenzen | angemessen – orientiert an nachgewiesener Leistungsfähigkeit, bekannten Grenzen und dem jeweiligen Risiko |
Die Forschung stützt Teilzusammenhänge des Wirkmodells
Empirische Arbeiten liefern Hinweise auf Zusammenhänge zwischen Vertrauen, Informationsaustausch, Transaktionskosten und Organisationsleistung. Sie stützen damit einzelne Teile des Wirkmodells.
Eine 2024 im Journal of Business Research veröffentlichte Metaanalyse wertete 60 empirische Studien zum Zusammenhang zwischen interorganisationalem Vertrauen und Leistung aus. Das Ergebnis: Sowohl kalkulierendes als auch relationales Vertrauen stehen in einem positiven Zusammenhang mit der Organisationsleistung. Die Analyse modelliert Informationsaustausch und Unsicherheit als Vermittlungsmechanismen für kalkulierendes Vertrauen sowie Kommunikation und Verbindlichkeit für relationales Vertrauen. [eprints.whiterose.ac.uk]
Eine ältere, aber besonders anschauliche Studie von Jeffrey H. Dyer und Wujin Chu untersuchte 344 Beziehungen zwischen Automobilherstellern und Zulieferern in den USA, Japan und Korea. Die Autoren fanden einen Zusammenhang zwischen wahrgenommener Vertrauenswürdigkeit, niedrigeren Transaktionskosten und intensiverem Informationsaustausch. Beim am wenigsten vertrauenswürdigen Automobilhersteller lagen die ermittelten Beschaffungstransaktionskosten fünfmal höher als beim vertrauenswürdigsten Hersteller. [jstor.org]
Der Befund veranschaulicht den möglichen Nutzen geringerer Abstimmungs- und Kontrollkosten, lässt sich aber nicht unmittelbar auf KI-Anwendungen übertragen.
Eine weitere Metaanalyse aus dem Jahr 2023 zeigt, dass Vertrauen grundsätzlich viele Formen sozialer Interaktion beeinflusst. Zugleich macht die Forschung deutlich, dass Vertrauen nicht einfach vorhanden ist. Es entsteht aus wahrgenommenen Eigenschaften des Gegenübers, aus Kontext, Erfahrung und der jeweiligen Risikosituation. [pmc.ncbi.nlm.nih.gov]
| Studie | Untersuchungsbasis | Befund | Einordnung |
|---|---|---|---|
| Bai et al. (2024) Journal of Business Research |
Metaanalyse, 60 empirische Studien | Kalkulierendes und relationales Vertrauen stehen in positivem Zusammenhang mit der Organisationsleistung | Kein direkter Nachweis einer KI-Vertrauensdividende |
| Dyer & Chu (2003) Organization Science |
344 Beziehungen zwischen Automobilherstellern und Zulieferern in USA, Japan und Korea | Beschaffungstransaktionskosten beim am wenigsten vertrauenswürdigen Hersteller fünfmal höher als beim vertrauenswürdigsten | Nicht unmittelbar auf KI-Anwendungen übertragbar |
| Hancock et al. (2023) Frontiers in Psychology |
Metaanalyse zu Einflussfaktoren von Vertrauen | Vertrauen entsteht aus wahrgenommenen Eigenschaften des Gegenübers, Kontext, Erfahrung und Risikosituation | Misst nicht den wirtschaftlichen Nutzen vertrauenswürdiger KI-Daten |
Für KI bedeutet das: Es gibt kein universelles Vertrauen in „die KI“. Menschen vertrauen einem bestimmten System, in einer bestimmten Situation, für eine bestimmte Aufgabe und bis zu einem bestimmten Risiko.
Was ist eine Vertrauensdividende bei Daten und KI?
Auf Daten und KI übertragen, verstehe ich unter Vertrauensdividende:
Die Vertrauensdividende ist der mögliche wirtschaftliche und organisatorische Nutzen einer begründeten Nutzung von Daten und KI-Ergebnissen. Sie kann entstehen, wenn Menschen sich innerhalb klarer Einsatzgrenzen auf überprüfbare Grundlagen stützen und dadurch weniger unnötig prüfen und abstimmen müssen - statt dieselben Fragen immer wieder neu zu klären.
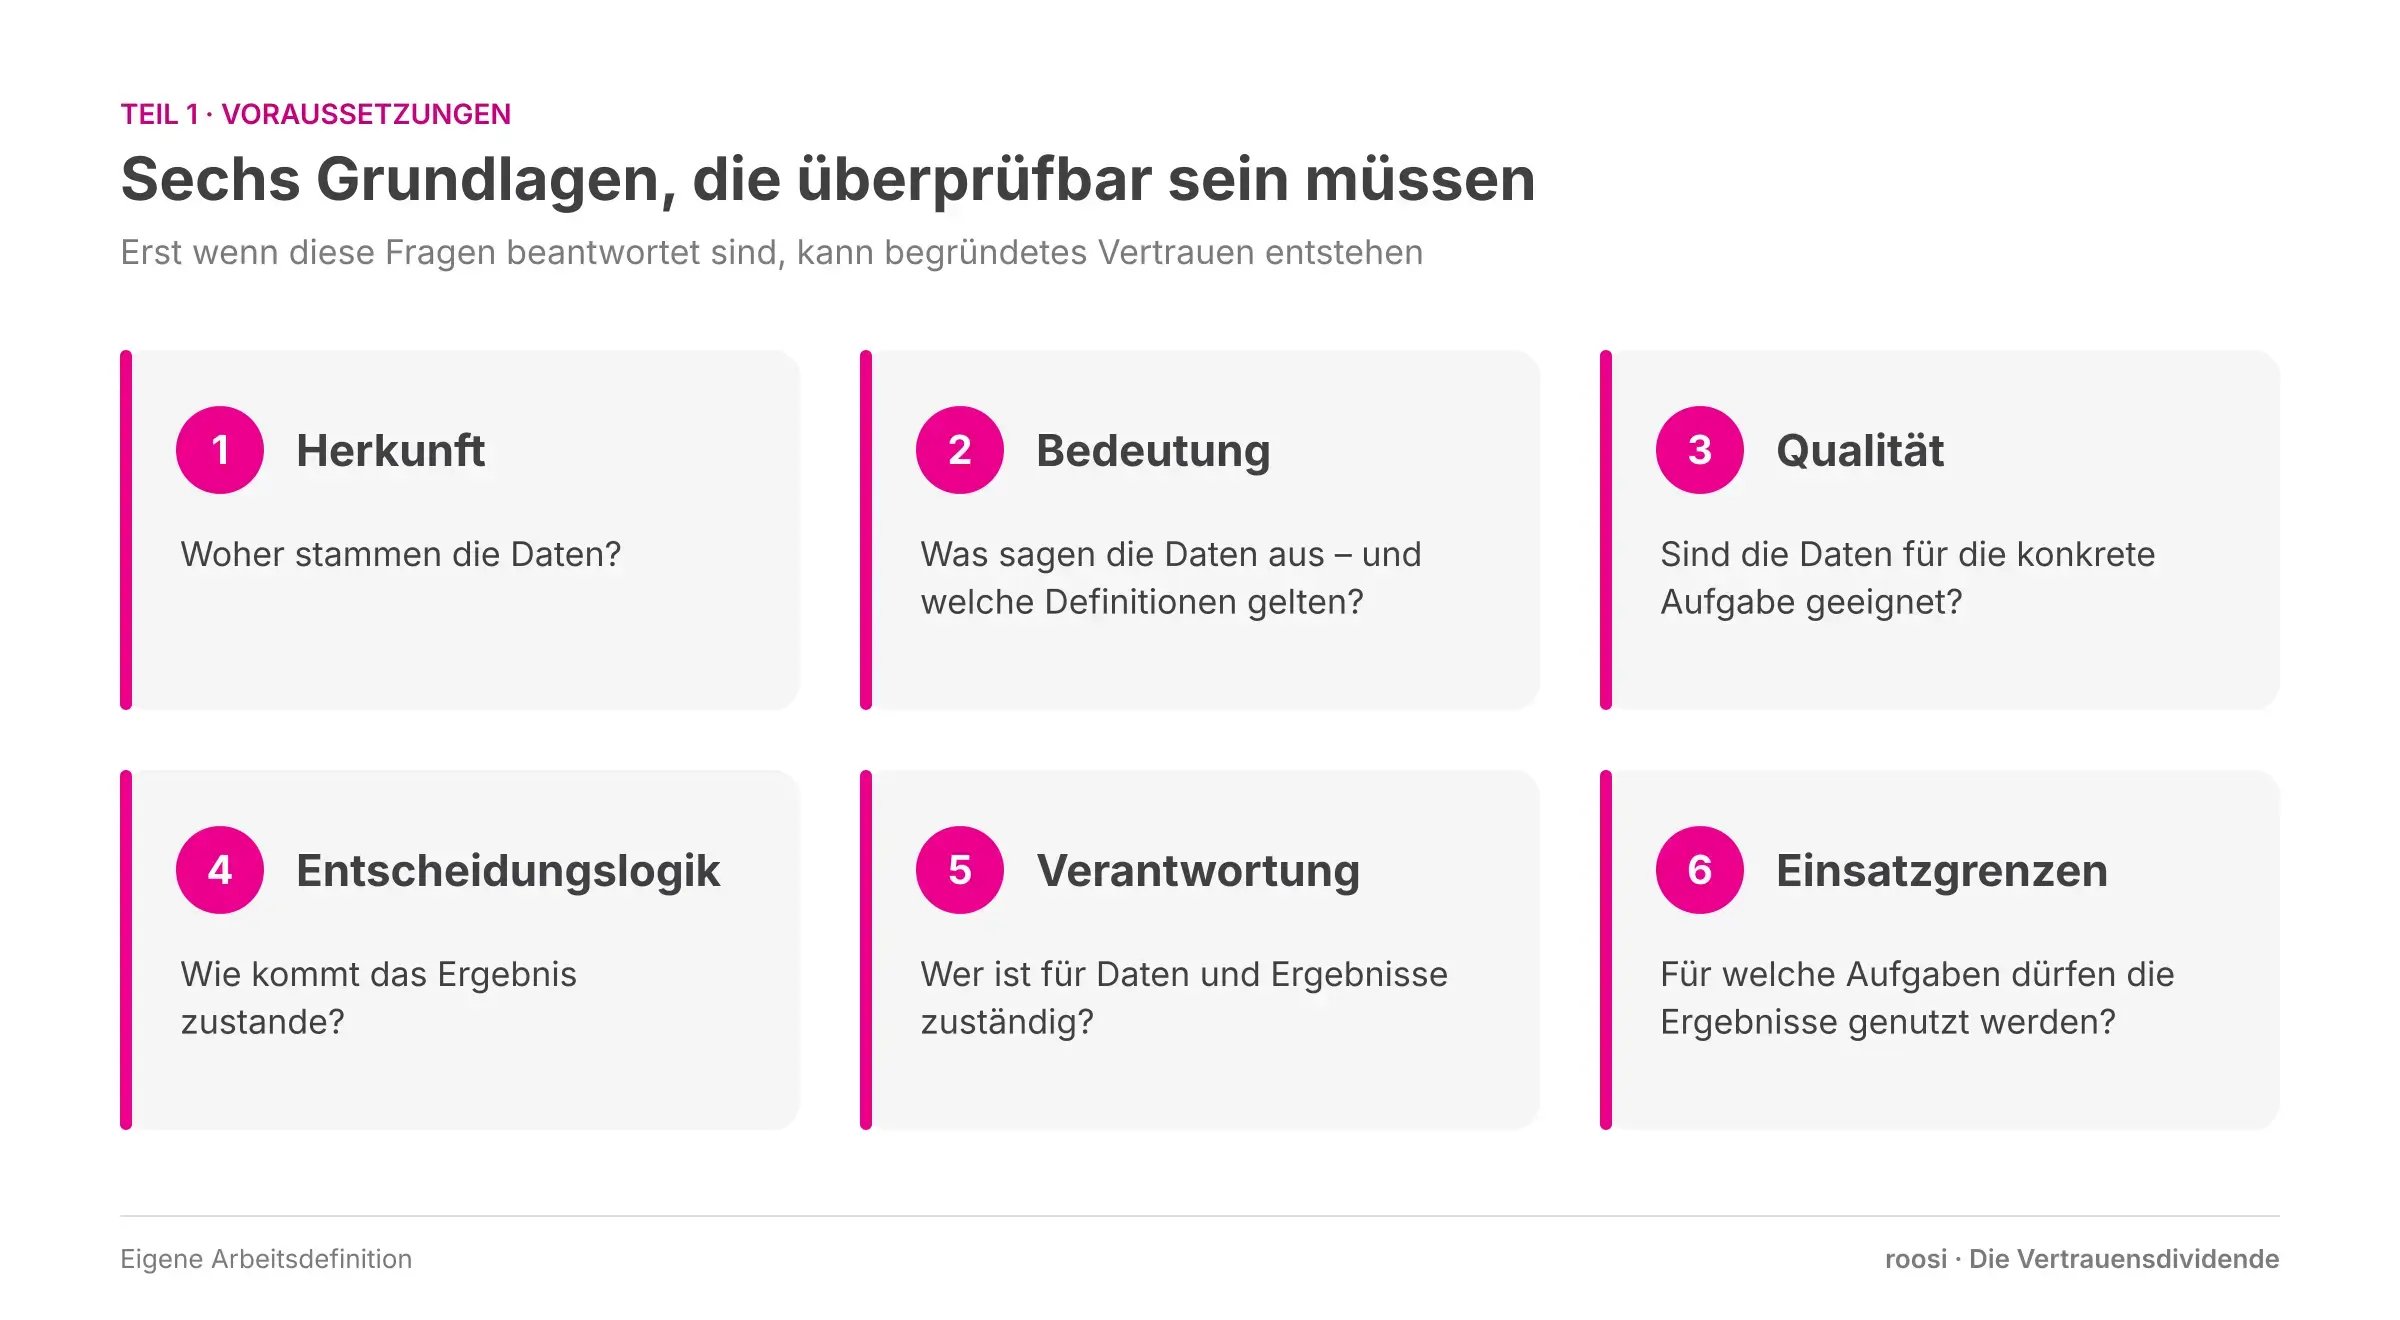
Dafür muss überprüfbar sein:
Herkunft: Woher stammen die Daten?
Bedeutung: Was sagen die Daten aus, und welche Definitionen gelten?
Qualität: Sind die Daten für die konkrete Aufgabe geeignet?
Entscheidungslogik: Wie kommt das Ergebnis zustande?
Verantwortung: Wer ist für Daten und Ergebnisse zuständig?
Einsatzgrenzen: Für welche Aufgaben dürfen die Ergebnisse genutzt werden?
Der angestrebte Gewinn ist konkret: weniger Aufwand, einfachere Zusammenarbeit und schnellere Entscheidungen. Sind die genannten Voraussetzungen erfüllt, können unnötige Prüfungen und Abstimmungen entfallen. Notwendige Kontrollen bleiben bestehen. Ob daraus tatsächlich ein Nutzen entsteht, muss sich im jeweiligen Anwendungsfall zeigen.
Je nach Anwendungsfall und Umsetzung könnte sich dieser Nutzen im Arbeitsalltag so zeigen:
-
Ein Vertriebsleiter muss nicht erst drei Berichte vergleichen, bevor er eine Kennzahl verwendet.
-
Eine Controllerin muss nicht jedes Mal nachfragen, welche Definition von Umsatz oder Deckungsbeitrag gemeint ist.
-
Ein KI-Assistent kann auf freigegebene und kontextualisierte Informationen zugreifen, statt unterschiedliche Dokumentversionen ungeprüft zu vermischen.
-
Eine Entscheidung kann schneller getroffen werden, weil Datenherkunft, Aktualität und Qualitätsstatus sichtbar sind.
-
Fehler werden früher erkannt, weil Regeln, Verantwortlichkeiten und Eskalationswege festgelegt sind.
-
Menschen können KI-Ergebnisse gezielt prüfen, statt vorsorglich jede Ausgabe vollständig neu zu erarbeiten.
Gemeinsam ist diesen Beispielen die mögliche Verringerung von Reibung - vorausgesetzt, Daten und Kontrollen sind für die Aufgabe geeignet.
KI kann den Nutzen guter Daten und die Kosten schlechter Daten verstärken
Diese Perspektive wird wichtiger, je autonomer KI-Systeme handeln.
Bei einem klassischen Bericht erkennt ein erfahrener Anwender möglicherweise, dass eine Zahl nicht plausibel ist. Ein KI-Agent kann dieselbe fehlerhafte Zahl dagegen in eine Zusammenfassung übernehmen, mit weiteren Informationen verbinden oder zum Ausgangspunkt einer Handlung machen.
Die State of Reliable AI Survey 2024 von Monte Carlo und Wakefield Research illustriert das Problem. Befragt wurden 200 Datenfachleute in den USA. 91 Prozent der befragten Führungskräfte aus dem Datenbereich gaben an, bereits generative KI-Produkte zu entwickeln oder entwickelt zu haben. Gleichzeitig waren 68 Prozent der Befragten nicht vollständig von der Qualität der zugrunde liegenden Daten überzeugt. Die Studie berichtet außerdem, dass zwei Drittel der Teams in den vorangegangenen sechs Monaten mindestens einen Datenvorfall mit Kosten von 100.000 US-Dollar oder mehr erlebt hatten. [info.montecarlodata.com], [montecarlo.ai]
Die Ergebnisse sind wegen der begrenzten US-Stichprobe und des Auftraggebers nicht ohne Weiteres auf alle Unternehmen übertragbar. Sie zeigen eine Spannung zwischen der Entwicklung generativer KI-Produkte und dem begrenzten Vertrauen in die zugrunde liegenden Daten. Daraus lässt sich weder ein Anstieg der Investitionen noch zwingend ein widersprüchliches Vorgehen ableiten: KI-Anwendungen und ihre Datenbasis können auch parallel weiterentwickelt werden.
Eine 2026 veröffentlichte Untersuchung von Accenture, die eine Befragung von Führungskräften aus 2.000 Unternehmen in 15 Ländern und neun Branchen einbezieht, kommt zu einem ähnlichen Ergebnis. Nur sieben Prozent der untersuchten Unternehmen wurden als weit genug entwickelt eingestuft, um über die erforderlichen Fähigkeiten für KI-fähige Daten im großen Maßstab zu verfügen. 72 Prozent verfügten nach eigener Angabe nicht über vertrauenswürdige Daten in der erforderlichen Qualität, verbunden mit standardisierten Governance-Praktiken. Mehr als 80 Prozent verzögerten, begrenzten oder veränderten zumindest gelegentlich KI-Initiativen aufgrund datenbezogener Risiken. [accenture.com]
| Wert | Befund | Quelle |
|---|---|---|
| 91 % | der befragten Führungskräfte aus dem Datenbereich entwickeln generative KI-Produkte oder haben sie entwickelt | Monte Carlo / Wakefield Research 2024 |
| 68 % | der Befragten sind nicht vollständig von der Qualität der zugrunde liegenden Daten überzeugt | Monte Carlo / Wakefield Research 2024 |
| 2/3 | der Teams hatten in sechs Monaten mindestens einen Datenvorfall mit Kosten von 100.000 US-Dollar oder mehr | Monte Carlo / Wakefield Research 2024 |
| 7 % | der Unternehmen verfügen über die erforderlichen Fähigkeiten für KI-fähige Daten im großen Maßstab | Accenture 2026 |
| 72 % | verfügen nicht über vertrauenswürdige Daten in der erforderlichen Qualität mit standardisierten Governance-Praktiken | Accenture 2026 |
| > 80 % | verzögern, begrenzen oder verändern KI-Initiativen zumindest gelegentlich aufgrund datenbezogener Risiken | Accenture 2026 |
Die Befragungen zeigen datenbezogene Hemmnisse der KI-Nutzung, isolieren aber nicht den Beitrag mangelnden Vertrauens. Mehr Vertrauen allein muss diese Hemmnisse daher nicht beseitigen.
Begründetes Vertrauen ist etwas anderes als blindes Vertrauen
Das National Institute of Standards and Technology beschreibt Vertrauenswürdigkeit von KI deshalb nicht als einzelne Eigenschaft. Im AI Risk Management Framework gehören dazu unter anderem Validität und Zuverlässigkeit, Sicherheit, Resilienz, Transparenz, Verantwortlichkeit, Erklärbarkeit, Datenschutz und der Umgang mit schädlicher Verzerrung. Welche Kriterien besonders wichtig sind, hängt vom jeweiligen Einsatzkontext ab. [nist.gov], [airc.nist.gov]
Das ist ein entscheidender Punkt: Vertrauen darf nicht mit Fehlerfreiheit verwechselt werden.
Fehlerfreiheit ist keine Voraussetzung für Vertrauenswürdigkeit; bloße Transparenz über Fehler reicht aber ebenfalls nicht aus. Ein System muss für seinen Einsatzzweck ausreichend zuverlässig und risikogerecht abgesichert sein. Seine Leistungsfähigkeit, Unsicherheiten und Grenzen müssen bekannt sein, Fehler erkannt und behandelt werden können. Umgekehrt kann ein System häufig richtige Ergebnisse liefern und dennoch nicht vertrauenswürdig sein, wenn unklar bleibt, welche Daten es verwendet, welche Informationen fehlen oder wer im Schadensfall verantwortlich ist.
| Was Vertrauenswürdigkeit erfordert | Was allein nicht ausreicht |
|---|---|
| Ausreichende Zuverlässigkeit für den Einsatzzweck | Fehlerfreiheit – sie ist keine Voraussetzung |
| Risikogerechte Absicherung | Bloße Transparenz über Fehler |
| Bekannte Leistungsfähigkeit, Unsicherheiten und Grenzen | Überzeugend formulierte Antworten |
| Fehler können erkannt und behandelt werden | Häufig richtige Ergebnisse, wenn unklar bleibt, welche Daten verwendet werden, welche Informationen fehlen oder wer im Schadensfall verantwortlich ist |
Im Wirkmodell entsteht eine mögliche Vertrauensdividende nicht durch weniger Kontrolle um jeden Preis, sondern durch bessere, risikogerechte Kontrolle, die unnötige Mehrfachprüfungen vermeidet, ohne notwendige Absicherung zu schwächen.
Statt jede Ausgabe vollständig neu zu prüfen, kontrolliert eine Organisation gezielt:
- Welche Datenquellen darf die KI verwenden?
- Wer verantwortet diese Daten?
- Wie aktuell und vollständig sind sie?
- Welche Definitionen und Geschäftsregeln gelten?
- Woher stammt eine Aussage?
- Welche Unsicherheit besteht?
- Welche Entscheidungen darf das System vorbereiten?
- Welche Handlungen darf es selbstständig ausführen?
- Wann ist eine menschliche Freigabe erforderlich?
Klare Antworten können improvisierte Kontrollen im Tagesgeschäft verringern.
Weiter mit Teil 2 der Serie: Von der Datenqualität zur Entscheidungsgeschwindigkeit →
Quellenhinweis und wissenschaftliche Einordnung
Coveys Management-Denkrahmen wird hier konzeptionell auf Daten und KI übertragen. Das daraus abgeleitete Wirkmodell ist plausibel und in Teilzusammenhängen empirisch gestützt, nicht als vollständige Kausalkette nachgewiesen. Richtung, Stärke und Rückkopplungen der Wirkungen sowie alternative Erklärungen bleiben anwendungsfallspezifisch zu untersuchen. Eine allgemein anerkannte, einheitlich berechenbare Kennzahl „KI-Vertrauensdividende“ ergibt sich daraus nicht.
Die Analysten- und Anbieterbefragungen von Monte Carlo, Accenture und anderen Organisationen liefern wertvolle Marktindikationen, sollten aber wegen Auftraggeber, Methodik und Stichprobenauswahl nicht mit unabhängigen Metaanalysen gleichgesetzt werden.
Quellen
- Covey, S. M. R.; Merrill, R. R. (2006): The Speed of Trust. Free Press. Katalog
- FranklinCovey (o. J.): Leading / Working at the Speed of Trust®. Kursbeschreibungen. Leading · Working
- Bai, J. et al. (2024): Calculative trust, relational trust, and organizational performance. Journal of Business Research 172. DOI · Manuskript
- Dyer, J. H.; Chu, W. (2003): The Role of Trustworthiness in Reducing Transaction Costs and Improving Performance. Organization Science 14(1). JSTOR
- Hancock, P. A. et al. (2023, Korrektur 2025): How and why humans trust. Frontiers in Psychology 14. Volltext
- Monte Carlo / Wakefield Research (2024): The State of Reliable AI Survey. Anbieterbefragung, 200 Befragte, USA. Bericht (PDF) · Zusammenfassung
- Accenture (2026): AI-ready data: New rules of data for the advanced AI era. Anbieterstudie. Online
- NIST (2023): AI Risk Management Framework (AI RMF 1.0), NIST AI 100-1. Übersicht · Kapitel 3
Abruf der Onlinequellen: 2. November 2026.